Сколько фотографий нужно, чтобы обучить компьютерное зрение на производстве
От чего зависит объём обучающих данных для системы компьютерного зрения: число классов дефектов, разнообразие условий съёмки, редкие случаи. Как собрать и разметить датасет и с чего начать, если брака почти нет.
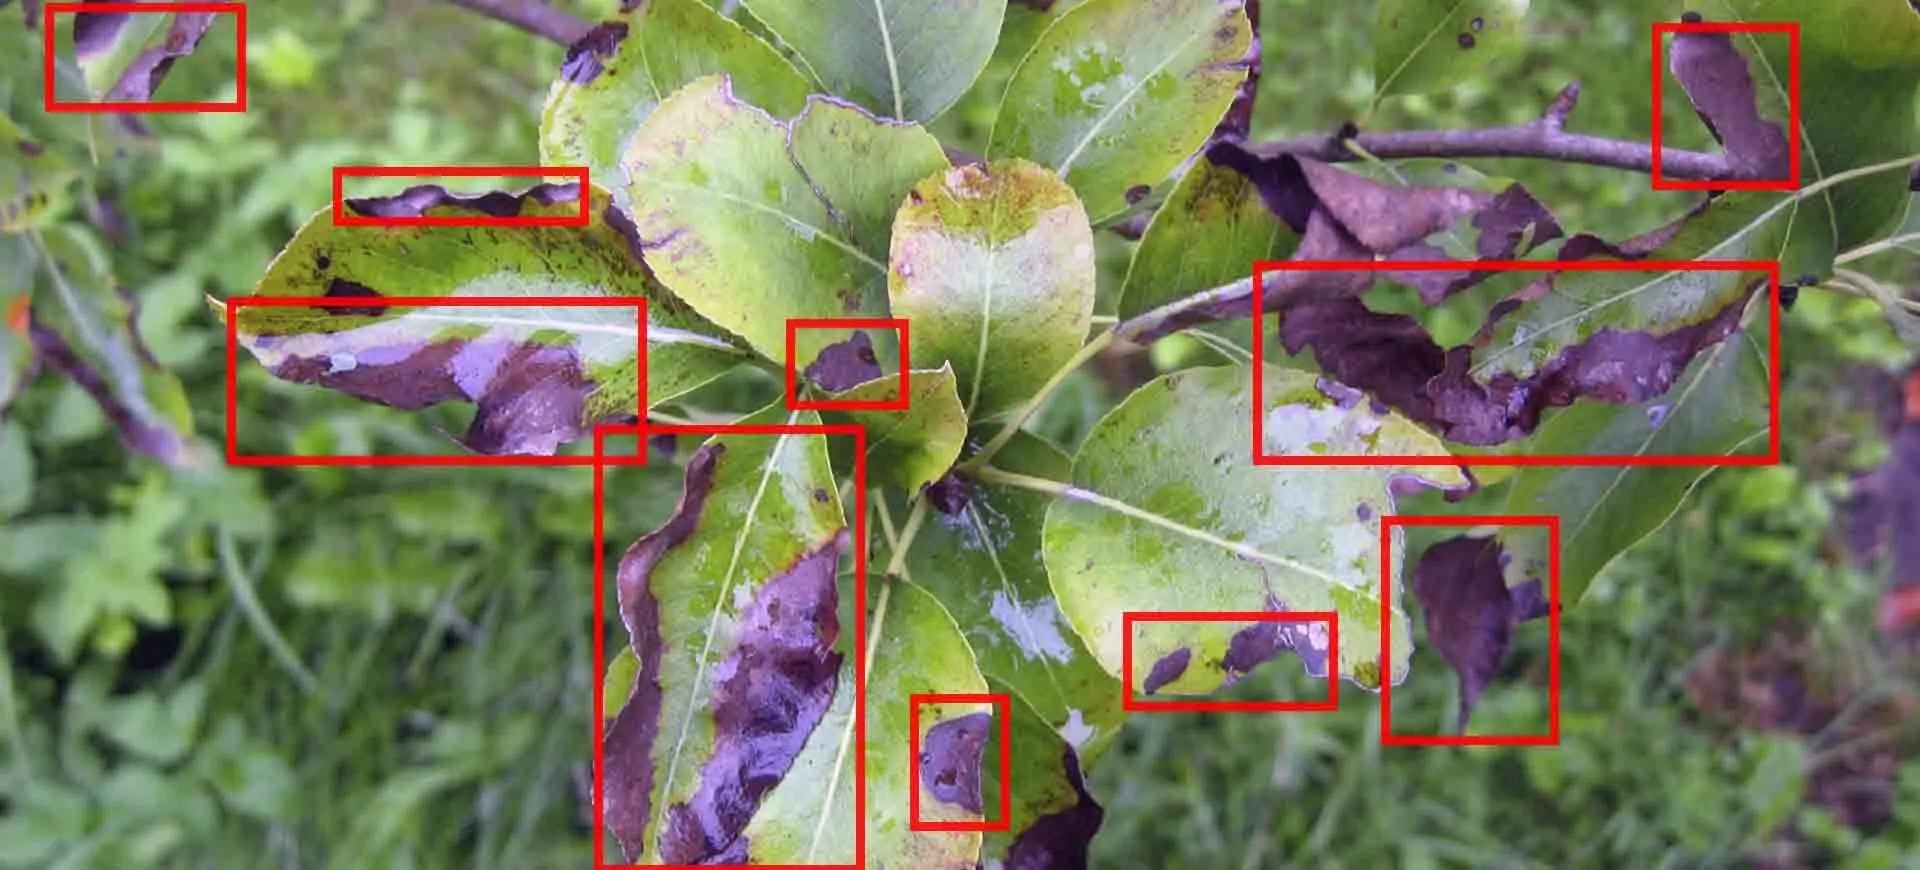
Первый вопрос, который задают перед проектом компьютерного зрения: сколько нужно фотографий. Честный ответ звучит как «зависит от задачи», но за ним стоят понятные факторы. Разберём, что влияет на объём данных, как его оценить заранее и что делать, если дефектов на производстве мало.
От чего зависит объём данных
Сколько разных объектов или дефектов нужно различать. Модели нужно увидеть достаточно примеров каждого класса. Задача «есть дефект или нет» требует меньше данных, чем различение десяти типов брака.
Насколько разнообразны условия. Если камера стоит в одном месте, свет постоянный, а изделия одинаковые, модель обучается быстрее. Смена освещения, разные партии сырья, несколько типоразмеров изделий, грязь на объективе увеличивают число нужных примеров: каждое такое условие должно быть представлено в данных.
Насколько заметен дефект. Крупный скол виден с первого взгляда, микротрещина на бликующей поверхности требует хорошей съёмки и большего числа примеров.
Какая нужна точность. Чем меньше допустимый процент пропусков и ложных срабатываний, тем больше примеров пограничных случаев нужно собрать и тем тщательнее размечать.
Ориентиры для старта
Точное число назвать без данных нельзя, но порядок можно оценить:
- для пилота, который показывает, решается ли задача в принципе, обычно хватает нескольких сотен размеченных изображений на класс;
- для промышленной эксплуатации датасет растёт до тысяч примеров и продолжает пополняться в процессе работы;
- важнее количества разнообразие: тысяча снимков одной и той же детали в одинаковых условиях полезна меньше, чем двести снимков в разных сменах, при разном свете и из разных партий.
Если используется предобученная модель, которую дообучают под задачу, примеров нужно заметно меньше, чем при обучении с нуля.
Если брака почти нет
На хорошо налаженном производстве дефектов мало, и собрать сотни примеров каждого типа трудно. Есть несколько подходов:
- Поиск аномалий. Модель учится на изображениях годных изделий и отмечает всё, что от них отличается. Такой подход позволяет начать почти без примеров брака.
- Накопление в процессе. Система запускается в режиме подсказки оператору, а спорные кадры сохраняются и размечаются. Через несколько недель датасет пополняется реальными дефектами.
- Аугментация и синтетика. Изображения поворачивают, меняют яркость и контраст, добавляют шум. Для некоторых задач дефекты можно дорисовать на снимках годных изделий. Это дополняет реальные данные, но не заменяет их.
Как собрать и разметить данные
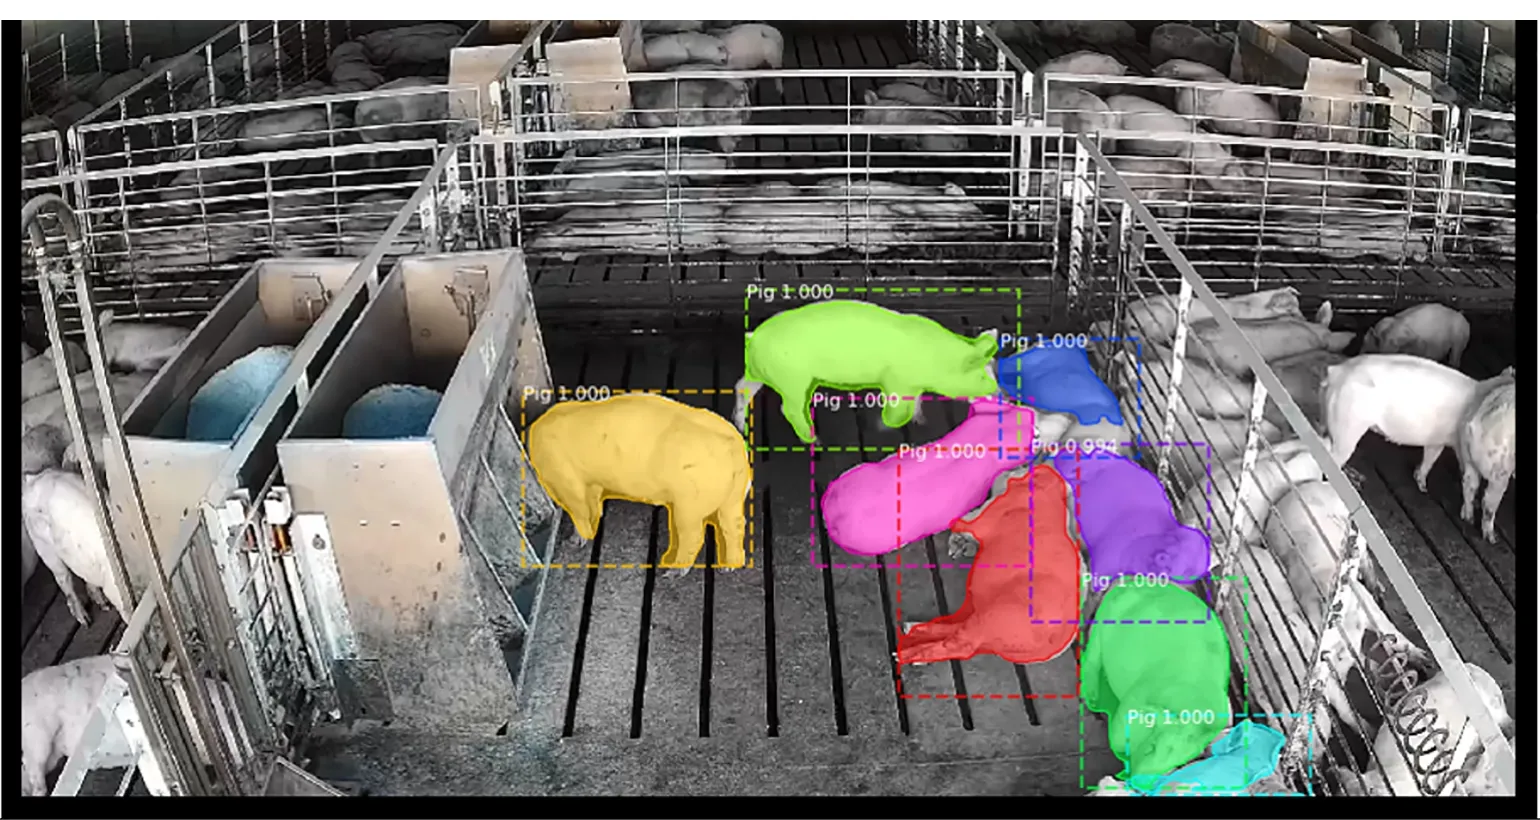
Разметка масками: каждое животное выделено отдельно. Кадр из кейса «Неинвазивное взвешивание свиней».
- Снимайте той камерой и в том месте, где будет работать система. Фото с телефона в офисе плохо переносятся на линию.
- Охватите разные смены, сезоны и партии. Так модель не сломается, когда изменится свет или поставщик сырья.
- Договоритесь о правилах разметки. Что считать дефектом, где проходит граница допустимого. Если два разметчика по-разному понимают брак, модель будет путаться так же.
- Отложите часть данных для проверки. Точность считают на снимках, которые модель не видела при обучении, иначе цифры будут завышены.
С чего начать
Перед проектом полезно собрать небольшой набор снимков с линии, даже несколько десятков, и описать, какие дефекты важны и как часто они встречаются. По этому набору можно оценить, хватит ли качества съёмки, какой подход подойдёт и сколько данных понадобится для пилота. Подробнее о том, из чего складывается бюджет такого проекта, в статье сколько стоит внедрение компьютерного зрения, а о том, как устроена сама система на линии, в статье как камера находит брак на конвейере.
Если хотите обсудить свою задачу, опишите её в заявке и приложите несколько снимков: инженер оценит, с чего лучше начать.